


Новейшие разработки «ДиКом Автоматизации» меняют место компании на логистическом рынке
Организация
Издательский дом «Инфра-М»

Россия
Отвечает на вопросы
Нестерова Альбина Николаевна (генеральный директор «Инфра-М»)

На ИСР-2026 обсуждали цифровой инжиниринг как фундамент индустриального суверенитета. О ключевых технологических трендах,
доступе к научному контенту, эволюции пользователя и безопасности генеративного ИИ рассказала Альбина Николаевна,
руководитель холдинга «ИНФРА-М».
СПРАВКА. «Инфра-М» — российский книгоиздательский холдинг, выпускающий научную и учебную литературу для средних профессиональных и высших учебных заведений, бизнеса, научных исследований, пост-вузовского образования. Основан в 1992 году. Главные тематические направления выпускаемой литературы: общественные науки — экономика, юриспруденция, бухгалтерский учёт, менеджмент, маркетинг, финансы; естественные науки, гуманитарные и педагогические науки, инженерное дело, технологии и технические науки.
В состав холдинга входят несколько специализированных издательств, собственная электронно-библиотечная система (ЭБС) Znanium, научные проекты Naukaru. Член Российской библиотечной ассоциации (РБА)
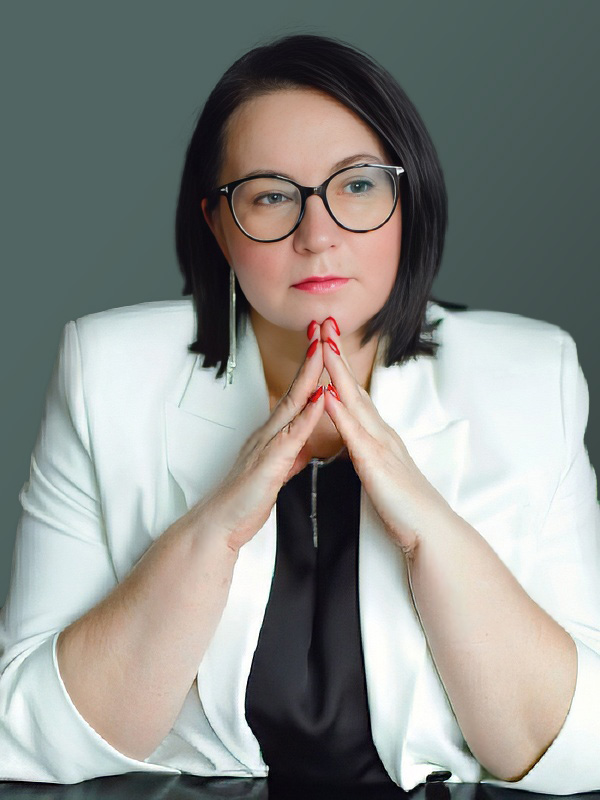
Нестерова Альбина Николаевна
Генеральный директор
Издательский дом «Инфра-М»
— На форуме «Инженерное собрание России 2026» обсуждались векторы развития инженерной мысли.
Какие из технологических трендов показались вам наиболее перспективными и значимыми для нашей страны?
— Прежде всего, хочу отметить саму повестку форума: «Цифровой инжиниринг как фундамент индустриального
суверенитета». Это предельно точная характеристика нашей сегодняшней реальности. Опираясь на дискуссии с коллегами, я бы выделила
три ключевых тренда, имеющих для России стратегическое значение.
Во-первых, повсеместное внедрение цифровых двойников на производствах. Этот вопрос активно поднимали
представители передовых инженерных школ и промышленных концернов.
Во-вторых, интеграция AI-агентов в работу инженерных подразделений. За этим стоит будущее проектирования и
эксплуатации производств. Здесь я хочу сделать важный акцент: речь идет не о замене человека алгоритмами, а о многократном усилении его компетенций.
Искусственный интеллект становится надежным ассистентом, который берет на себя рутину и повышает эффективность бизнес-процессов.
В-третьих, трансформация инженерно-технической подготовки кадров. Мы видим, как виртуальные лаборатории и
умные системы интегрируются непосредственно в учебный процесс.
Как руководитель холдинга, обеспечивающего информационную поддержку науки, я смотрю на эти тренды под
особым углом. Любые технологии — будь то цифровые двойники, AI-агенты или новые образовательные среды — требуют одного критически
важного ресурса: качественно структурированных и верифицированных данных.
Инженерная мысль не может развиваться в вакууме, опираясь на информационный шум или
источники, которым нельзя доверять.
Чтобы строить передовую промышленность, нашим специалистам необходим мгновенный доступ к патентам,
новейшим научным статьям и нормативно-технической литературе. Именно в формировании этого интеллектуального фундамента мы в «ИНФРА-М»
видим свою главную задачу.
— После 2022 года российские учёные утратили доступ к Scopus и Web of Science. Но эти системы были не
просто базами данных, а метрическими инструментами, на которые ориентировались и специалисты, и люди, принимающие решения.
Есть ли сегодня какие-то ответы на этот вызов?
— Действительно, из-за санкционного давления российские исследователи потеряли доступ к части аналитических систем.
Однако я бы не назвала эту ситуацию критичной. И вот почему.
Необходимо четко разделять сами научные публикации и наукометрические базы. Scopus и Web of Science работают как
аналитическая надстройка: они агрегируют данные, оценивают статьи и рассчитывают индексы. Да, доступ к этим зарубежным метрикам для нас
закрыт, но сами полные тексты никуда не исчезли. Благодаря проекту Минобрнауки «Национальная подписка на зарубежные базы данных»,
сотрудники отечественных университетов и НИИ продолжают бесплатно получать свежие статьи из огромного массива международных журналов.
Иными словами, мы не отрезаны от мирового научного знания.
Что касается метрик — безусловно, удобно, когда кто-то уже измерил вес статьи за тебя. Но давайте будем
реалистами: у компетентного ученого всегда хватает критического мышления, чтобы самостоятельно оценить значимость публикации.
Достаточно посмотреть на название журнала, репутацию издателя и аффилиации авторов, чтобы отличить прорывное исследование от работы
начинающего специалиста.
Не бывает учёных, которые занимаются всеми областями наук, каждый исследователь идет по своей узкой
специализации. Спросите любого ученого, и он без запинки назовет вам десяток ведущих журналов по своему профилю. Научная периодика не
появляется каждый день — за каждым солидным изданием стоят авторитетная редколлегия и строгий отбор. Российскому исследователю не
обязательно знать, какой конкретно индекс получила свежая статья в Science или Nature — 15 или 18. Он априори доверяет качественному
фильтру этих изданий.
Кроме того, в России активно формируется собственный инструмент оценки. Некоторое время назад стартовал
проект «Белый список журналов», задача которого — создать национальный индекс цитирования как отечественных, так и зарубежных публикаций,
опираясь на значимые для нас критерии.
Фактически это шаг к суверенной альтернативе Scopus. Фундамент уже заложен, и, по заявлениям операторов проекта,
в ближайшие годы Россия получит полноценную, независимую наукометрическую систему.
— Ранее мы затронули тему того, что метрики нужны не только самим исследователям, но и тем,
кто принимает решения. Это важный аспект: руководителям тоже нужны объективные ориентиры.
— Безусловно. Наукометрия — это, в первую очередь, управленческий инструмент.
Проректору по науке в вузе или руководителю НИИ необходимо четко понимать результативность своих сотрудников.
Метрики отражают уровень цитируемости, а значит — реальный вес научной идеи и масштаб интереса к ней со стороны
академического сообщества.
Один исследователь может публиковать десятки проходных статей, которые останутся незамеченными.
Другой напишет одну работу, которая соберет тысячи цитирований за год, потому что в ней заложен прорывной смысл.
Управленцам любого уровня нужны объективные данные, чтобы выявлять авторов самых перспективных идей и грамотно выстраивать систему
их мотивации.
В российских университетах эта задача успешно решается через эффективные контракты: размер
финансового поощрения напрямую зависит от категории издания и уровня цитируемости публикации. Чем выше резонанс от статьи в
научном мире, тем большее вознаграждение получает автор. И это абсолютно справедливо, ведь своими достижениями он повышает
авторитет и престиж всей научной школы, которую представляет.
— Как, на ваш взгляд, меняются запросы современных инженеров и технических вузов к информационным
ресурсам? Чего им не хватает сегодня больше всего? И как эволюционировал профиль пользователя за последние годы?
— Если мы составим портрет нашего пользователя — инженера или исследователя,
регулярно участвующего в НИР, — то для наглядности я бы взяла ретроспективу в десять лет. За этот период произошел колоссальный скачок.
Ученые не живут в вакууме, и главный триггер, меняющий их привычки, — это развитие цифровых инструментов,
в первую очередь искусственного интеллекта.
Десять лет назад алгоритм работы с информацией был преимущественно ручным. Исследователь знал десяток
ведущих профильных журналов и раз в месяц просматривал свежие выпуски. Это был привычный, понятный, но очень ограниченный путь.
Следующей вехой стал семантический поиск. Пользователю стало тесно в рамках знакомых изданий —
он захотел видеть картину мира целиком. От поисковика стали ждать понимания контекста: учета синонимов, нечетких формулировок,
мультиязычности. Семантические алгоритмы и дискавери-сервисы (от англ. discover — «обнаруживать») позволили выявлять десятки тысяч
релевантных статей, патентов и диссертаций далеко за пределами привычного фокуса внимания. Исследователь вдруг обнаруживал,
что прорывные идеи публикуются в смежных дисциплинах или в свежих мировых патентах, отследить которые вручную просто не хватило бы времени.
Сегодняшний день — это эпоха генеративного искусственного интеллекта. Мы перешли на новый уровень:
ИИ не только находит информацию, но и помогает ее «прочитать». Когда дискавери-система выдает 25 тысяч документов по узкой предметной
области, человек физически не способен их изучить. И здесь в игру вступают ИИ-ассистенты на базе больших языковых моделей.
Сейчас типичный сложный запрос от исследователя звучит так: «Проанализируй массив и опиши ключевые
концепции, появившиеся по моей теме за последние два года». ИИ-ассистент мгновенно считывает гигантский объем публикаций,
стирает языковые барьеры и выдает структурированную выжимку, например, на русском языке: «За этот период сформировалось 10
новых концепций. Первую разрабатывает вот этот авторский коллектив, вторую — вот этот исследователь». То, на что раньше ушли
бы месяцы кропотливой работы в библиотеках, сегодня делается за несколько минут.
Поведение пользователей меняется вслед за технологиями: их запросы становятся всё сложнее и масштабнее.
И это абсолютно закономерно. До появления генеративных нейросетей ни одна машина не могла осмысленно проанализировать текст вместо человека.
Теперь это наша новая реальность.
— Но здесь есть и большой плюс, и некий минус: человека как бы несколько ведут. Он узнаёт только то,
что искусственный интеллект предоставил ему. Искать за рамками предложенного человек уже не станет. Нет ли здесь некой зависимости,
которая может привести к проблемам?
— Я отвечу философски: всё есть яд, и всё есть лекарство. Это лишь инструмент. С одной стороны,
технологический прогресс предоставляет нам доселе невиданные возможности и в быту, и в профессиональной деятельности.
Но, с другой стороны, у всего есть своя цена. В данном случае плата за комфорт — необходимость постоянно прокачивать «мышцу»
критического мышления.
— Это как раз подводит нас к одной из самых больных тем современной науки — проблеме
конфабуляций генеративного ИИ*. Расскажите подробнее: как именно сервисы вашего холдинга решают эту проблему?
Как ИИ может быть безопасным для учёного?
* Конфабуляция (также встречается название «галлюцинация») — термин в области искусственного интеллекта (ИИ),
который обозначает ответ, сгенерированный ИИ и содержащий ложные или вводящие в заблуждение сведения, представляемые как факт.
— В интернете появляется всё больше не просто фейкового контента, созданного человеком по незнанию,
но и синтетического, который сгенерировали нейросети. В чём здесь глобальная разница? Когда человек пишет научную работу,
он своим именем берет на себя ответственность за написанное. Когда текст генерирует нейросеть — ответственности нет.
Это просто программа, которая математически связала близкие по смыслу слова.
Это можно сравнить с походом к врачу. Доктор выписывает вам рецепт на лекарства и ставит под ним
свою подпись, свое имя. Другое дело, если пациент обратится к генеративному ИИ и попросит назначить лечение под свои симптомы.
Машина тоже выдаст список препаратов. Но если что-то пойдет не так, в первом случае пациент придет к врачу, и тот обязан будет
нести ответственность. Во втором случае предъявлять претензии чат-боту бессмысленно. Мы четко понимаем эту разницу — она именно в
ответственности.
Второй момент: о работе с информацией и критическом мышлении сейчас говорят даже школьникам.
Но в чём кроется главная проблема? Синтетические тексты становятся всё более человекоподобными. Визуально или стилистически уже очень
сложно отличить, написала это машина или конкретный человек. Поэтому критически важно получать ответы из верифицированных источников.
Верифицированный источник — это публикация, у которой есть автор и издательство. Это означает, что с текстом работали живые люди,
которые своими именами ручаются за его содержание.
Именно поэтому в нашем дискавери-сервисе «Неопоиск», где проиндексировано уже 145 миллионов документов,
у каждого материала есть автор, название издательства и первоисточник. Инженеру или исследователю не нужно каждую секунду включать
критическое мышление и сомневаться, можно ли верить найденной статье. Он уверен, что 100% контента в системе верифицировано.
Внедряя ИИ-ассистента, мы сразу объясняем пользователю: наш алгоритм работает в замкнутом контуре
только по проиндексированному научному контенту. Он не выходит в открытый интернет. Мы фиксируем это в договоре-оферте и берем на себя
ответственность за то, что проверенные данные не будут подменены «галлюцинациями» без автора.
В этом мы видим естественную трансформацию контентных платформ.
Холдинг «ИНФРА-М» работает на рынке IT-решений и контента для науки и образования с 1991 года.
Тридцать пять лет назад мы начинали с печатных книг, затем пришла эра интернета, электронных учебников и онлайн-курсов.
Сейчас наступил новый виток. Драйвером трансформации выступает технологический прогресс: появились генеративные технологии,
и ими хочется пользоваться. Чтобы они приносили только пользу и не вредили науке, мы, как производители контента,
соединяем мощь нейросетей с закрытым корпусом проверенных текстов.
И еще один важный аспект, о котором стоит упомянуть, — инструменты для написания научно-исследовательских
работ (НИР). Помимо обычного поиска, мы предлагаем классификацию документов по рубрикам ВАК. Мы понимаем, что у каждого исследователя
свои паттерны работы — всего существует около 50 сценариев поиска научной информации, и мы стараемся учесть их все.
Если ученому привычно искать материалы исключительно по коду своей специальности ВАК, по которой он защищал диссертацию,
мы даем ему такую возможность.
— Какой коллектив работал над вашим решением, с кем вы кооперировались?
— Проект «Неопоиск» родился в недрах холдинга «ИНФРА-М», где собраны специалисты, глубоко понимающие специфику
как научного контента, так и IT-технологий. Сегодня в нашей компании работает около 200 человек. Проект стартовал силами внутренней команды,
но мы четко осознавали: чтобы написать собственный движок семантического поиска с нуля, потребовались бы колоссальные затраты времени и
усилий. Поэтому мы привлекли партнеров, которые предоставили нам лицензию на готовую поисковую технологию. Встроив её в систему,
мы сосредоточились на том, в чем заключается наша главная экспертиза. Например, весь масштабный процесс индексации массива данных реализуют
исключительно наши штатные сотрудники, которые наработали в этой сфере уникальные компетенции.
— Сегодня много говорят о технологическом суверенитете России. Согласны ли вы с тем, что суверенная наука
невозможна без суверенной цифровой инфраструктуры знаний? И какую роль холдинг «ИНФРА-М» играет в этом процессе?
— Абсолютно согласна. И здесь важно посмотреть на ситуацию шире, в контексте общемировых трендов.
Если мы оглянемся на пять-десять лет назад, доминирующей идеей была тотальная глобализация. Считалось, что наука не имеет границ,
она стоит над государствами, а все исследования должны аккумулироваться в единых базах вроде Scopus и Web of Science.
Цель казалась благородной: любой пользователь из любой точки планеты мог увидеть, что происходит в мировой науке по
интересующей его теме.
Однако после 2022 года — и речь не только о политических событиях, но и о фундаментальных,
тектонических сдвигах в международных отношениях — эта парадигма начала рушиться. Если десятилетиями считалось престижным
демонстрировать достижения своих ученых на «мировом Олимпе», то в последние годы маятник качнулся в противоположную сторону.
На первый план вышли вопросы безопасности и суверенитета.
Государства осознали риски: абсолютная открытость может вести к краже идей и потере технологического
лидерства, к тому же большинство современных разработок имеют двойное назначение. Поэтому многие страны начали осознанно «закрывать»
чувствительные разделы своей науки.
Яркий пример — Китай. Они целенаправленно ограничивают свое присутствие в международных базах данных и
закрывают для индексации не только полные тексты статей, но даже метаданные. Делается это для того, чтобы зарубежные исследователи не
могли даже приблизительно оценить векторы китайских разработок. Другой пример — Соединенные Штаты. В 2025–2026 годах администрация
Дональда Трампа выпустила ряд директив, ограничивающих открытую публикацию чувствительных исследований в сфере IT и
искусственного интеллекта.
В этих условиях создание собственной, независимой инфраструктуры знаний для России — это уже не вопрос
амбиций, а вопрос национальной безопасности. Отечественные ученые и инженеры должны иметь бесперебойный доступ к верифицированной
информации и передовым инструментам аналитики, вне зависимости от внешних ограничений. Именно в этом холдинг «ИНФРА-М» видит свою
стратегическую задачу. Развивая такие решения, как «Неопоиск», мы строим тот самый интеллектуальный фундамент, который позволит
нашей науке и промышленности оставаться сильными, суверенными и конкурентоспособными.
Беседу провёл генеральный директор портала «SMMEXPO» Сергей Мануйлов.

